关于Flow Matching的一些想法
Flow matching杂谈
本文不含严谨数学推导
本来宏图大志想写很多数学推导,写着写着发现数学水平有限根本推不出来。同时,真正实用的几乎只有最后的几句话,且形式极其简单…
初始的Normalizing Flow(NF)是离散的,用一个可逆变换$f$,一步一步把标准高斯分布$N(0, I)$变换(推)到目标数据分布$p_{data}$上,从而能够对数据分布进行采样。
最简单的形式Residual Flow,每一步推一点: $f_k(x)=x+\delta v_k(x)$
Continuous NF(CNF)定义了一(类)连续变换,变换过程可以用归一化的时间$t\in[0,1]$表示。
\(x_t=\phi_t(x_0)=x_0+\int_0^t u_t(\phi_s(x_0))\text{d}s\) 把$t$看成变量,$\phi_t(x_0)$就是初始点$x_0$的变换轨迹。
表示成微分的形式就是 \(\frac{d}{dt} x_t = v_t(x_t)\)
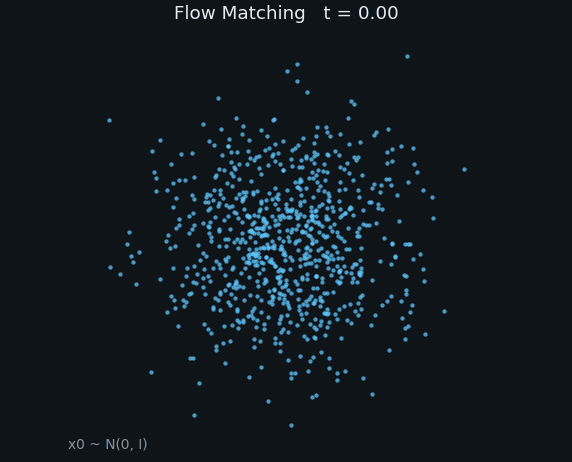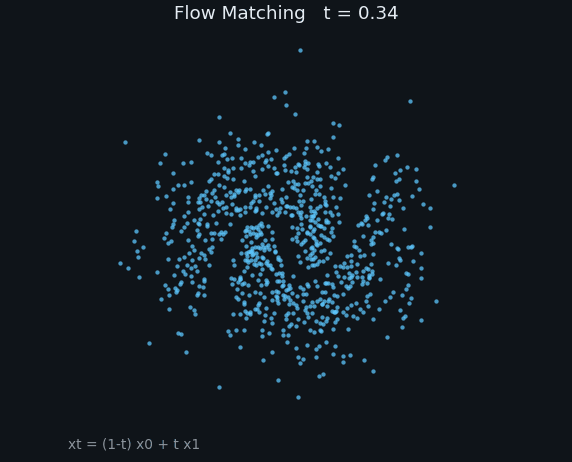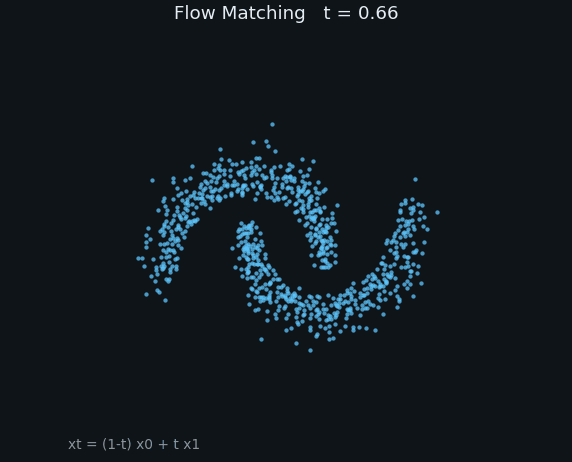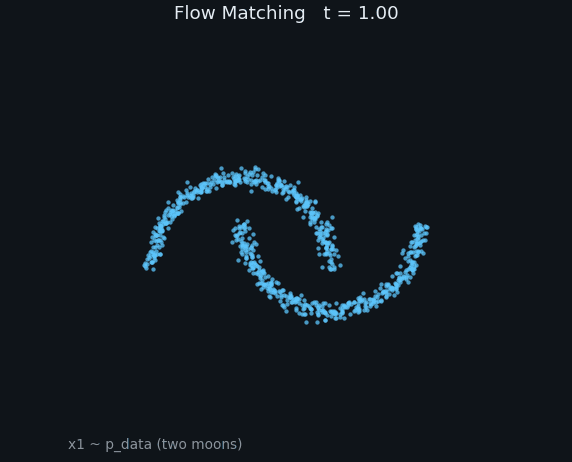
$v_t$是一个向量场,含义为$t$时刻空间中每个点的瞬时速度。
要做生成,目标自然是想办法建模这个速度$v$,比如说用个神经网络,设为$v_{\theta}(x,t)$,问题是如何优化它。
根据“输运方程” (transport equation),可以建立起一个任意时刻$t$,速度场$v_t$和$x$被推到当下的概率分布$p_t(x)$的偏微分方程。建立起与概率分布的关系以后就可以想办法去推极大似然估计的目标函数。当然,这个函数很不好算。
Flow Matching干的事是,直接去优化速度场,即想办法优化。 \(\mathbb E_{t\sim \mathcal{U}[0,1],x\sim p_t}[||v_\theta(x,t)-v(x,t)||^2]\)
训练过程中,你采样了$t$,我们要想办法对每个t都找一个“速度场”出来,还得采样出相应的$x$,难搞。
CFM引入了一个额外的条件,直接取最终目标$x_1$来辅助(似曾相识啊)。 证明了 \(\mathbb E_{t\sim \mathcal{U}[0,1],x\sim p_t,x_1\sim p_1}[||v_\theta(x,t)-v(x|x_1,t)||^2]\) 和前面的期望,关于$\theta$的梯度是一致的。这里$p_1$就是数据分布$p_{data}$。这个以$x_1$为条件的速度场,意思就是说目标分布坍缩到了一个确定的点,$p_1(x)=[x==x_1]$,再去规划这个速度。
关于这一点,最能共情数学不好的同学们的豆包老师给了一个通俗的解释
所谓速度场$v_t(x)$,实际上就是所有经过$x$这个点的条件速度场的期望 \(v_t(x)=\mathbb E_{x_1\sim p_{1|t}}[v(x|x_1,t)]\) 而前面的损失函数是个MSE,MSE的估计出的极小值点就在目标的均值。
事实上,速度场你是可以随便定义的,只要满足能推到目标分布就行。问题在于数据分布很乱,一开始的FM损失函数你根本没法找一个“能推到完整数据分布的向量场的解析式”。但是当有了目标点作为条件,你就只需要找一个“能推到某一个点的场”,这就简单得多了。最简单的例子就是直接取线性变换:
\[v(x|x_1,t) = \frac{x_1-x}{1-t}\]从而$x_t=(1-t)x_0+tx_1$。在训练过程中,采样的是$x_0$,$x_t$是算出来的,那么就是 \(v(x|x_1,t)=x_1-x_0\)
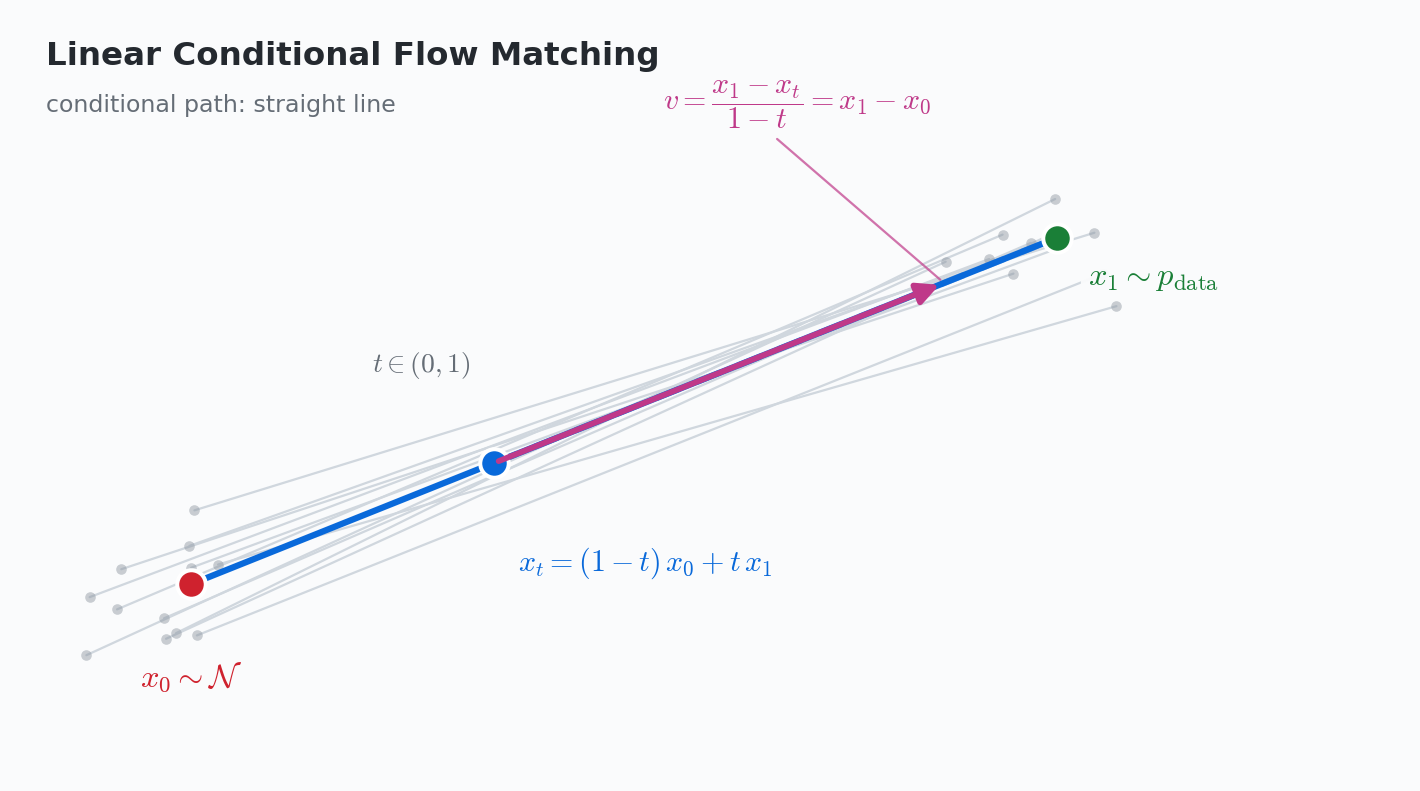
当然,没人规定非得线性变换不可,只是它简单,好用。
这里还涉及到另一个问题,同时采样$x\sim p_t$和$x_1\sim p_1$,又是这么高维的空间,真能学明白吗?
一方面,你完全可以说“相信大模型的力量”。另一方面,也可以想办法搞优化。一个自然的洞见是,随机采样的配对会搞的速度场很乱,路径容易交叉,梯度混乱。
OT(Optimal Transport)-CFM就对一个batch的所有采样的$x_0$和$x_1$,找总欧氏距离最近的匹配,尽可能避免交叉,但是要付出额外的计算匹配的成本。
Explorative Modeling这个工作是进一步的延申。采多个目标点找最近,或者采多个噪声点找最近,把OT的双边匹配改成了单边找最近点,实验证明确实能够加速收敛。
不过这篇工作本身把minibatch OT批判了一通。认为OT是全局匹配的有偏近似,并且实验结论为minibatch OT会损害性能。
OT hurts performance at both model sizes, which we attribute to the bias of minibatch couplings and their model-agnostic assignment.
除此之外,还有x-prediction和v-prediction, x-loss和v-loss的区别。x-pred就是直接去预测最终的$x_1$,然后算出$v_t$。x-loss是类似的。它们可以自由组合,也可以用x-pred+v—loss这样。具体怎么样训更好,暂时就不分析了,有空可以琢磨琢磨。
简单一点代码
尽管现在都是code agent写了,最好还是懂点基础算法的代码,免得面试被问写不出来,让别人感觉你很菜,看了这么多理论白看。
训练(线性 CFM)和采样可以压成下面这几行。目标速度在直线路径上就是常数 $x_1-x_0$(等价于 $\frac{x_1-x_t}{1-t}$):
# ---- train (linear CFM) ----
for x1 in dataloader:                    # x1 ~ p_data
    x0 = torch.randn_like(x1)            # x0 ~ N(0, I)
    t  = torch.rand(len(x1), 1, ...)      # t ~ U[0,1],广播到和 x 同形状

    xt = (1 - t) * x0 + t * x1           # 条件路径上的点
    vt = x1 - x0                         # 条件速度(沿路径恒定)

    loss = ((v_theta(xt, t) - vt) ** 2).mean()
    loss.backward(); opt.step(); opt.zero_grad()

# ---- sample (Euler ODE) ----
x = torch.randn(n, *shape)               # 从噪声出发
for i in range(n_steps):
    t = i / n_steps
    x = x + (1 / n_steps) * v_theta(x, t)  # dx/dt = v_theta(x, t)
# x ≈ x1 ~ p_data